pythonでTIFFの情報を読み取るコードを作成する(1)
pythonでTIFFの情報を読み取るコードを作成します。
コードを作ってみたら結構長いコードができあがってしまったので何回かに分けて整理しておきたいと思います。今回はコードの概要についてです。
機能の定義
最初に作りたいコードの機能を考えてみます。
- 最初のIFDの情報を読み取る(IFDが複数あることが多いですが簡単のため今回は最初のIFDのみにする)
- IFD内のタグ、型、データの個数、値をcsvに出力する
- 1エントリー1行で記載する
- タグに対応したタグの名前もタグの隣に記載する
コードの概要
プログラムを書き始めますが、その前に日本語で整理してみます。
Taglistの読み込み
タグに対応したタグ名を表示するためのリストを読み込んでおきます。
画像の読み込み
画像(DNG)をバイナリ形式で読み込みます。
IFHの情報を読む
IFHから、データの並べ方(ByteOrder)、ファイル形式(File Type)、つぎのIFDへのオフセットを取得します。
最初のIFDの情報を読む
EntryCount
エントリーの数を取得します。
Enty
各エントリーのタグ、ファイル形式、データの個数、値を取得します。
データの書き出し
取得したエントリーの情報をcsvに保存します。
次の記事から、この概要に沿ってプログラムを書いていきます。
画像のバイナリデータからTIFFの情報を見てみる
実際にDNGをバイナリエディタ(またはLinuxコマンド)でTIFFの情報をのぞいてみます。
カメラの画像データDNGをバイナリエディタで見てみます。
ImageFileHeader

ByteOrder
先頭2バイトは4949(II)で、データの並び順はLittleEndian(アドレスの小さい順にデータを並べる形式)です。
FileType
次の2バイトはLittleEndianで読むと002A(42)となっていて、TIFF構造で読んでいけばいいことがわかります。
OffsetIFD
さらに次の4バイトは00000008となっていて、次のIFDは8バイト目から始まります。
ImageFileDirectory

EntryCount
次のIFDの先頭バイトは002Dとなっていて、このIFDには45個のエントリーが入っていることがわかります。
Entry
1番目のエントリーを見てみます。
Tag
NewSubfileType(00FE.H)で、このIFDの画像の種類を定義するタグです。
Type
データ形式はLONG(32bit符号なし整数、0004.H)
Count
データの個数は1個(0001.H)
32bit符号なし整数で、データの個数が1個なので、データのサイズは4バイト(4byte*1個)なので、Valueには値が入ることがわかります(4バイトを超える場合は値までのオフセット値になる)。
Value
NewSubfileTypeの画像の種類*1は以下のようなものがあります。
| 値(10進数) | 説明 |
| 0 | メイン画像 |
| 1 | 縮小画像 |
| 2 | マルチページ画像の一部 |
| 4 | 透過マスク画像 |
値は1なので、このIFDの画像は縮小画像ということがわかります。
最後にこの次のエントリーにはどのような情報が入っているでしょうか*2。
TIFFの構造
TIFF (Tagged Image File Format/ティフ) は異なるメーカーのスキャナーやソフト間でも、画像を正しくやり取りできるための共通のファイル形式として作られました。
TIFFで定義されたデータの情報をどのように保存するかのルールはJPEGやDNGなどにも拡張されていて、画像のメタデータを読むための基礎になっています。
ここではTIFFの構造をまとめました。
TIFFの構造は以下の通りです。
ImageFileHeader(ファイルの形式やデータの読み方が書いてあるブロック)と少なくとも1つのImageFileDirectory(情報が格納されているボックス)から構成されます。
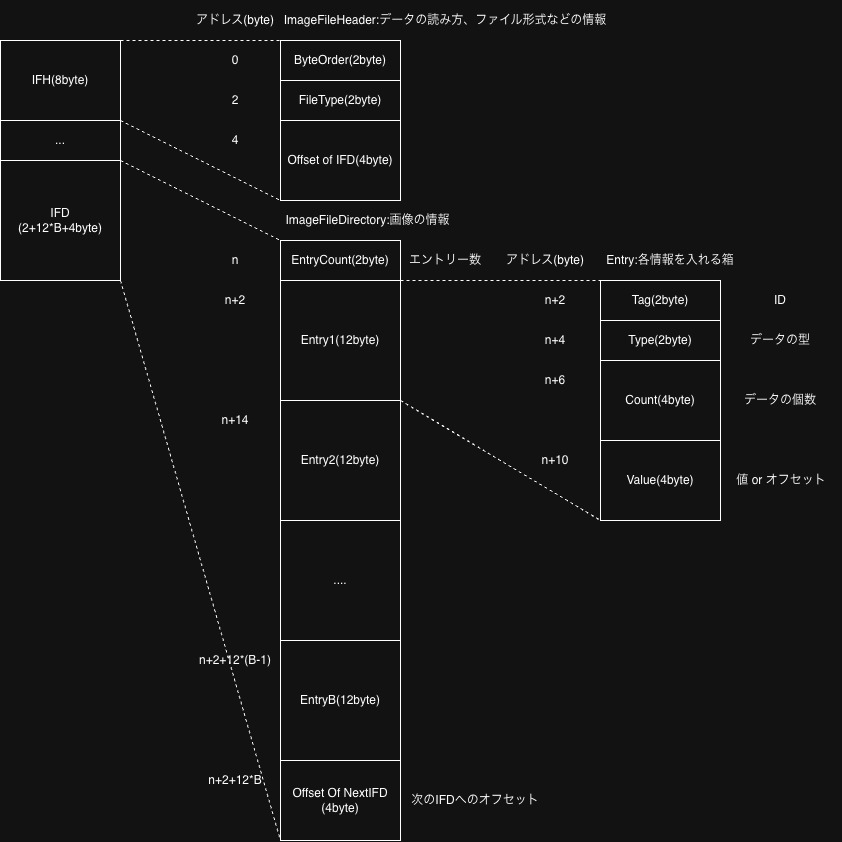
ImageFileHeader(8byte)
IFHはTIFFの始まりを表す8バイトのデータで、データの格納順や、ファイルの種類といったデータを読み始める前に必要な情報が入っています。
ByteOrder(2byte)
0-1バイト目にはデータをどのような順番で読めばいいのかが記載されています。
並び順には以下のようなものがあります。
- ll(4949.H) LittleEndian:アドレスの小さい順にデータを並べる
- MM(4D4D.H) BigEndian:アドレスの大きい順にデータを並べる
FileType(2byte)
2-3バイト目にはファイルの種類、42が固定で入っています。この値はTIFFのバージョン情報と言われていますが、TIFFのバージョン(現在は6.0)が変わってもこの値は変化せず、実質TIFFを示すマジックナンバーになっています。
OffsetOfIFD(4byte)
4-7バイト目は次のIFDまでのオフセット値です。オフセットはTIFFの先頭から数えた値です。
例えばオフセット値が8の場合は、TIFFの先頭から数えて8バイト目が次のIFDのデータの開始位置になります。
ImageFileDirectory
IFDは画像の情報(画像のサイズ、解像度、色空間など)を格納するブロックです。情報は各エントリーに格納されます。
EntryCount(2byte)
IFDに格納するエントリーの個数です。
Entry(12byte)
エントリーにはデータのタグ(ID)、型、個数、値が入っています。
Tag(2byte)
データのIDです。
タグの値とそれが何の情報なのかが紐づいていて*1、例えば、282(11A.H)ならXResolution(水平方向の解像度)というようにタグの値で、何の情報なのかがわかります。
Type(2byte)
データの型です。型には以下のようなものがあります。
| 型 | サイズ(byte) | 説明 |
|
1 = BYTE |
1 |
8bit符号なし整数 0〜255 |
|
2 = ASCII |
1 | 7bitASCII文字 |
|
3 = SHORT |
2 |
16bit符号なし整数 0〜65536 |
|
4 = LONG |
4 | 32bit符号なし整数 |
|
5 = RATIONAL |
8 |
符号なし小数 分子(4byte整数)/分母(4byte整数) |
|
6 = SBYTE |
1 |
8bit符号付き整数 -128〜127 |
|
7 = UNDEFINED |
1 | 自由形式 |
|
8 = SSHORT |
2 |
16bit符号付き整数 |
| 9 = SLONG | 4 | 32bit符号付き整数 |
| 10 = SRATIONAL | 8 |
符号あり小数 分子(4byte整数)/分母(4byte整数) |
| 11 = FLOAT | 4 | 単精度不動小数 |
| 12 = DOUBLE | 8 | 倍精度不動小数 |
Count(4byte)
データの個数です。
Value(4byte)
値が4バイトに収まるなら値を記載し、それを超える場合は、値までのオフセット値を記載します。
左詰で格納することに注意です。4バイト未満の場合、例えば0x1234を左詰で格納すると以下のようになります。4バイト未満なので足りないところは0で埋めます。
| 左詰で格納 | |
| BigEndian | 12340000 |
| LittleEndian | 34120000 |
LittleEndianはその方式に従って値を読み込めばいいですが(0は無視されるので)、ビッグエンディアンはそのまま読み込むと0x12340000(305397760)となり、元の値0x1234(4660)から変わってしまいます。エントリーの型から値のバイトがわかりますので、4バイト未満の場合は、先頭からそのバイト分だけデータを取り出し、各エンディアンに従って値を読み込むといいと思います。
値が4バイトに収まるかどうかは、データの型と個数から判断できます。例えば、あるエントリーの型がSHORT(2byte)のデータ数が3の場合、データサイズは6byte(=2byte*3個)なので、Valueはオフセット値だと判断できます。
OffsetOfNextIFD(4byte)
次のIFDへのオフセット値です。もし次のIFDがない場合は0を入れます。
以上がTIFFの構造の概要でした。
*1:詳細はTIFF Specificationなどで検索して出てくるTIFFの仕様書を参照してください。
バイナリデータの基礎
私たちがスマートフォンやパソコンで目にする文字や画像は0と1の2進数(バイナリ)でできていています。でもそれをみることができないのは文書や写真を表示するソフトで2進数から人が見やすい形式に変換されているから。
ここではテキストを例に、人が読める形式からバイナリデータにどのように変換されていくのかを見ていきます。
文章を書いてみる
まず、テキストエディタを開き、Helloと書いてテキストを保存してみます。
もしlinuxコマンドを使えたら
echo Hello > test.txt
で簡単に作成できます。Helloをtest.txtに出力するという意味です。
文章をバイナリデータで見てみる
次にこのテキストファイルをバイナリデータで見てみます。
バイナリデータでみるにはバイナリエディタでテキストファイルを開くのが簡単です。windosの場合はStiring、macの場合はHexFiendが有名です。
以下はHexFiendで開いてみた結果です。
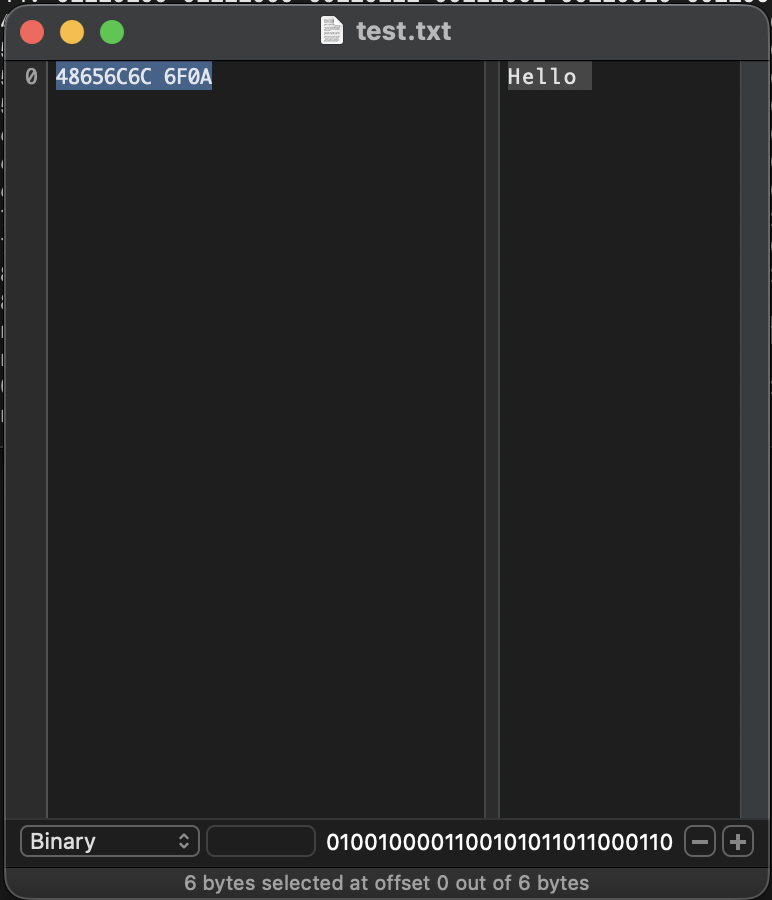
左がHelloの16進表記です。2進数で見たい場合は、マウスで見たい範囲を選択し、一番下の表記選択でbinary表記を選ぶと確認できます。01001...と2進数で並んでいますよね。
linuxコマンドでもみることができます。
16進数で表示したい場合は
xxd test.txt
オプションでbinaryをつけると2進数で表示できます。
xxd -b test.txt
16進数表記は4865 6c6c 6f0a
2進数表記は01001000 01100101 01101100 01101100 01101111 00001010
となっていて、HexFiendでの表記と一致しています。
バイナリから文字に変換してみる
16進数から文字に変換するためのルールがアスキーコード表です。
4865 6C6C 6F0Aを左から順に2バイトづつ読んで文字に変換していきます。
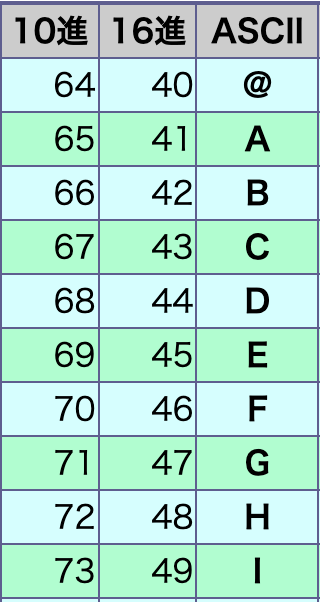
16進数の48に対応しているのは大文字のHです。
続けて65はe、6Cはl、6Fはo、0aはLF(改行)です。
以上から16進数48656c6c6f0aをHello(改行)に変換できました。
データの読み方のルール
先ほどはデータを左から右に読んでいきました。このようにデータを左側(アドレスの小さい方)から読んでいく方法をBig endianといいます。
また逆に右側(アドレスの大きい方)からデータを読んでいく方法をLittle endianといいます。
大体データの先頭にどの方式で読めばいいのかが明記されているので、そのルールに従ってデータを読んでいきます。
次回は画像データの読み方の基本TIFFの構造についてです。
画像や動画の撮影情報を取得する
画像や動画の撮影情報を抜き出すコードを作成するために勉強した内容をまとめていきます。
- バイナリデータの基礎
- TIFFの構造
- 画像のバイナリデータからTIFFの情報を見てみる
- pythonでTIFFの情報を読み取るコードを作成する
Catlog board2のトラブルシューティング
飼っている猫さんが去年の9月の健康診断で膀胱炎になり(ストラバイト結晶と細菌が検出され)、お薬と治療食で良くなったりまた悪くなったりを繰り返しています。尿の量を測定して変化に早めに気づけたらと思い使ってみることにしました。
Catlog board2は猫のトイレの下にボードを置いておくと、猫さんがトイレに入った時に体重や排泄の記録をアプリに送信してくれる製品です。2024年2月時点でボード(6930円)とアプリ月額(980円)で体調を観察することができます。
設置の際につまづいたところがあり、原因がわかるのに時間がかかってしまったので、対応の仕方をまとめてみました。
トイレを設置する
設置方法に従ってトイレを設置したりWi-Fiを繋ぎCatlog boardがスタンバイ状態になったのを確認できた(「トイレは寝ています( ˘ω˘ )スヤァ…」というメッセージが出ていたのでアプリとボードの通信もできているはず)ので、猫さんがトイレをするのを待ちました。朝6時ごろご飯を食べた後、トイレに行ったので測定されるのを待っていましたが、全く通知が来ません_| ̄|○
ログが記録されない時の確認事項をチェック
まずログが記録されないときの確認事項から設置に問題がないか確認しましたが、この中で特に該当しそうな項目はありませんでした。
設置の仕方に問題はなさそうだったので、あとはWi-Fi設定に何か問題があるのかもと関連記事をひとつづつ読んでいたところ、気になる一文を見つけました。
Aterm WG1200HS4をお使いいただいている場合、ルーターの設定によってはCatlogをご利用いただけない場合がございます。
本ルーターをお使いの場合に猫様のデータが更新されない場合には、まずはルーターの設定において『PPPoE』という接続方法が有効になっているかご確認ください。
※ルーターの設定を変更する方法については、ルーターのメーカー様またはご契約のプロバイダー様に直接お問い合わせください。
IPv6に対応していなかった
製品名に若干心当たりがあり確認したところ、家で使っているWi-Fiホームルーターです...IPv6に対応したホームルーターなのですがCatlog board2はIPv6に対応していないのだそうです。またWi-Fiの周波数2.4GHz以外の周波数が混在しない方がいいそうです。
無線ルーターの設定項目の記事に従い、ルーターの方式を変更して無事ログを記録することができましたが、高速で安定したWi-FiのためにIPv6や5GHzといった環境を作っていたので、若干残念なところでした。
私はうっかり確認しそびれてしまいましたが、購入前に対応するWi-Fi環境を確認して購入した方が安全です。
Catlog board設置方法
ログが記録されない時チェック項目
G検定2023#5

機械学習の知識の整理のためにG検定を受けました。G検定はAI・ディープラーニングの活⽤リテラシー習得のための検定試験で、年に数回(2023年は5回)開催されています。試験はweb形式で自宅で受験できます。
受けようと思ったきっかけ
1年ほど前から機械学習に関する仕事に関わり始め、仕事で必要な部分を適宜勉強していました。物体検出のタスクでも自然言語処理に使われるモデルを使用するなど、体系的に知識が必要と感じ、どう勉強するのが効率的か調べていた時に見つけて受けることにしました。
G検定のシラバス
人工知能の定義や歴史から始まり、ディープラーニングのタスクや手法、AI開発時に気をつけるべき点(開発をスムーズに進める方法、法律や倫理の話など)、活用事例がG検定の出題範囲です。AIを使ったシステムを企画する人から開発する人まで幅広い部門の人が知っておくと良い内容になっています。
試験に出てくる頻度はディープラーニングの手法に関する出題がやや多いので、数学が得意でない人は若干難しいと感じるかもしれません。私の場合は、特にディープラーニングの手法や活用について勉強したかったので、効率よく勉強できて良かったです。
最新のモデルについて知りたいという方には向いていませんが、有名な手法やその背景などを知っておくことで、現在の最新の手法を理解する足掛かりになるような知識を身につけられるというイメージです。
学習期間
7月から10月まで3ヶ月ほど勉強しました。大体1日2時間ほど(累計すると180時間ほど)です。
よく勉強時間は30時間ほどと書かれていますが、ディープラーニングの手法をきちんと理解したいという目的があり、そこに時間をかけたので長めの勉強時間になっています。
使用教材
学習教材は以下のものを使いました。
出題範囲の確認
https://www.amazon.co.jp/dp/4798165948
G検定の出題範囲を一通り学べるテキストです。
この本で出題範囲をざっと確認しました。各章の最後に確認用の問題もついています。必要最低限のことがシンプルに書かれているので、ディープラーニング手法をより深く理解したい場合は、別の詳しい教材が必要だと思います。
ディープラーニングの手法の理解
O'Reilly Japan - ゼロから作るDeep Learning
O'Reilly Japan - ゼロから作るDeep Learning ❷
O'Reilly Japan - ゼロから作るDeep Learning ❹
CNN、自然言語処理、強化学習についてきちんと理解したい場合は、ゼロから作るDeepLearningシリーズが良いです。丁寧な解説で理論的に仕組みを理解できます。Pythonを使って実際にディープラーニングを動かす事もできます。
試験対策
最短突破 ディープラーニングG検定(ジェネラリスト)問題集 第2版:書籍案内|技術評論社
試験対策の問題集にも取り組みました。問題のバリエーションがあり、web模試(1回)もついています。問題集の問題は公式問題集よりも深い内容が問われやや難しいです。web模試では現在のディープラーニング事情(海外の規制など)を問う問題もあってさらに難易度が高く感じました。web模試では実際の試験時間と同じ2時間で200問の試験問題を解くので問題を解く時間感覚を体験できます。
参考書を常に持ち歩くのは大変なので、隙間時間の勉強にG検定対策アプリも使いました。苦手分野がわかるのでそこに集中して取り組めました。
公式テキストを0.5ヶ月、その後ゼロから作るディープラーニング(3冊)を2ヶ月、残りの0.5ヶ月を試験対策の勉強にしました。公式テキストと問題集は3回ほど読んで試験対策しました。
2023#5の試験
試験開始前
11月11日の13時から開始の試験を受けました。試験開始前の試験の数日前に届いた案内リンクにアクセスして試験環境の確認などを行います。12時50分から13時10分の間に試験をスタートできます。それ以前またはそれ以降に試験を開始することはできません。スタートボタンを押すと時間がカウントされ後戻りができないので、お手洗いなど試験の準備整えて試験を始めます。
試験問題
試験は191問でした。見直しの時間なしで一問当たり1分半になります。問題は分野ごとに出題されずランダムに問題が出てきます。解答に時間がかかりそうな問題は未解答、解答に自信のない問題は「後で見直す」にチェックを入れて、即答できる問題を一通り回答してしまいます。サクサク進めれば30分は時間が余ったので、残りの時間に未解答の問題に取り組んだり、自信のない問題を考え直したりしましたが、一つ一つ検索する時間はなかったです。私は名前が覚えにくい勾配降下法の種類やモデルの名前とその特徴を表にしたものをまとめた表を準備しました。
web模試で出たような海外の規制などの問題が多かったら厳しいかもと思ったのですが、そういう問題は少なかったです。計算問題や数学的な知識を問う問題も少なかったです(計算問題は2問で、平均、分散、標準偏差の計算ができれば解答できる問題でした)。当日お腹の調子が非常に悪くトイレに何度か行ったので自宅受験で良かったです。
試験後
合否結果
2週間後にメールで合否結果がメールで届きます。
2023#5の合格者の割合は69%でした。
■合否結果
=================
【 合 格 】
=================
総受験者数 5,330名
合格者数 3,662名
■シラバス分野別得点率(小数点以下切り捨て)
1.人工知能とは. 人工知能をめぐる動向. 人工知能分野の問題:100%
2.機械学習の具体的手法:91%
3.ディープラーニングの概要:87%
4.ディープラーニングの手法:95%
5.ディープラーニングの社会実装に向けて:77%
6.数理・統計:83%
7.法律・倫理・社会問題:78%
※総合得点率、設問個別の正解・不正解、本試験の合格ライン等は
自然言語と法律関係が苦手で点数が取れなかったと思われます。
合格認証ロゴ
名刺などに載せることのできるロゴです。
合否結果のメールと一緒にダウンロードリンクとパスワードが届きます。
このブログの冒頭のロゴは合格認証ロゴの一つです。
合格証
1ヶ月後にPDFで届きます。
オープンバッジ
合格者のデジタル認定証明。
再受験クーポン
期間中に再受験チケットを購入すると50%オフクーポンがいただけます。
合格者コミュニティCDLEへの招待
G検定やE検定に合格した人のコミュニティCDLEを活用できます。わからないことがあったときに質問したり、情報共有するコミュニティです。まだ使いこなせていませんが、学生の参加が多いように思いました。
G検定は意味があるのか
よく「G検定」で検索すると「意味がない」というキーワードが出てきます。試験に受かるためだけの暗記勉強をした人にとっては意味がないかもしれませんが、AIを正しく活用するためにどんな手法で作られているのか、どんな点に気をつけるべきかをきちんと理解するという目的を持って取り組んだ人にとっては意味のある検定かなと思いました。AIの発展はとても早いのでG検定で問われる内容も時が経つと変わってくるのかなという感じがあります。知識をアップデートするのに時々活用したいなと思います。
